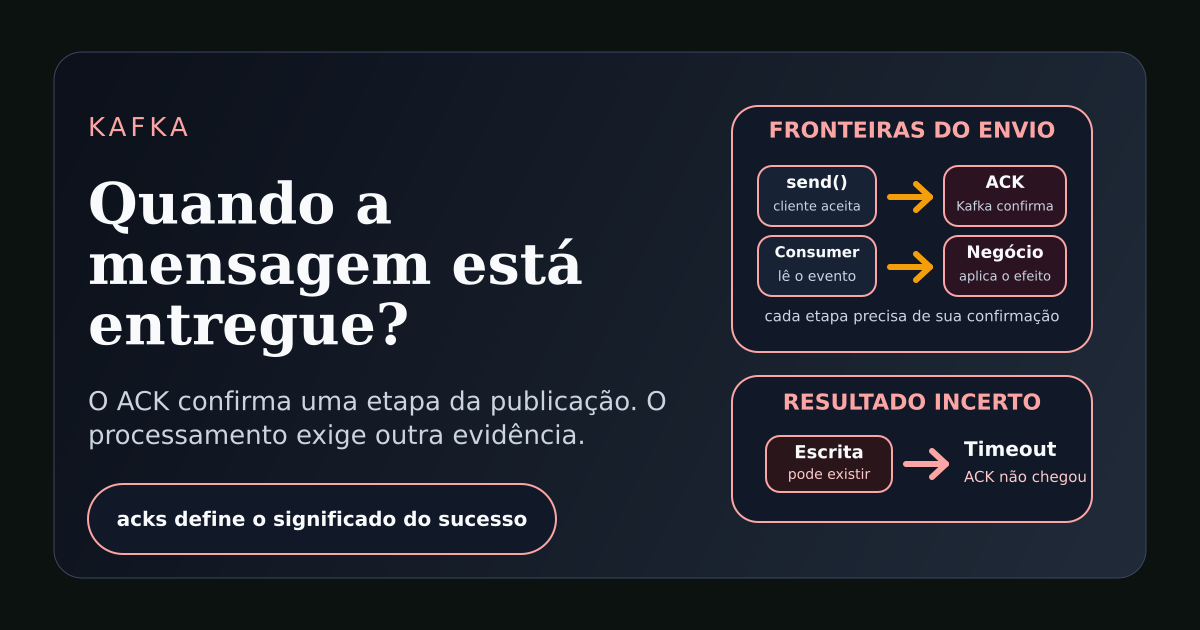
O log da aplicação diz que o evento foi enviado.
Minutos depois, alguém pergunta por que o pedido ainda não apareceu no serviço de faturamento.
O time abre o código e encontra um producer.send(...) seguido de uma mensagem de sucesso. Parece suficiente para encerrar a investigação do lado do produtor.
Mas o que aquele sucesso representa?
O registro entrou no buffer do cliente? O leader confirmou a escrita? As réplicas acompanharam? O consumer executou a regra de negócio?
Esses momentos têm consequências diferentes. Chamar todos de “mensagem entregue” esconde justamente a informação necessária para investigar uma falha.
No post sobre entrega e processamento, discutimos a fronteira do consumer. Agora vale olhar para a outra ponta: qual evidência permite ao producer considerar que terminou seu trabalho?
Retornar de send() ainda não confirma a escrita
No cliente Java, send() é assíncrono. O retorno normal entrega um Future; a conclusão do envio precisa ser observada depois. Colocar um log imediatamente após a chamada pode registrar apenas que o cliente aceitou o envio.
Um exemplo mínimo ajuda a separar os momentos:
producer.send(record, (metadata, exception) -> {
    if (exception != null) {
        log.error("Publicação não confirmada: eventId={}", eventId, exception);
        return;
    }

    log.info("Envio concluído: eventId={}, topic={}, partition={}, offset={}",
        eventId, metadata.topic(), metadata.partition(), metadata.offset());
});
A chamada também pode falhar antes dessa conclusão, por exemplo durante a serialização. Por isso o callback não substitui o tratamento de exceções da própria chamada. A API oficial do KafkaProducer descreve esse contrato.
O exemplo só observa o resultado. Em um fluxo real, registrar uma exceção não preserva sozinho a intenção de publicação: alguém precisa decidir como recuperar o evento.
E mesmo o callback sem erro exige uma segunda pergunta: com qual configuração de confirmação esse producer está operando?
A configuração acks define a evidência
acks muda o significado da conclusão bem-sucedida do envio:
Com acks=0, o cliente considera o envio concluído sem esperar uma confirmação do broker. O producer não tem evidência de que o registro foi recebido, e o offset retornado é -1.
Com acks=1, o leader confirma a escrita no seu log local. Essa resposta chega sem esperar que todos os followers tenham replicado o registro.
Com acks=all, o leader confirma depois que as réplicas do conjunto ISR reconhecem o registro, respeitando a condição de min.insync.replicas.
Esses comportamentos estão definidos na documentação de acks.
Imagine um evento OrderCreated. Com acks=0, a aplicação não recebeu uma resposta do broker que prove sua aceitação. Com acks=1, existe confirmação do leader, mas uma queda antes da replicação pode causar perda. Com acks=all, a confirmação tem uma condição de replicação mais forte.
A escolha precisa corresponder ao compromisso do produto. Se uma API responde que a publicação foi confirmada, a evidência observada pelo código precisa sustentar essa resposta.
Nenhuma dessas opções inclui esperar o faturamento terminar. O ACK da produção pertence ao protocolo de escrita.
All não significa todas as réplicas configuradas
Considere uma partição com três réplicas: A, B e C.
A é o leader. B e C acompanham o log. Quando as três estão no ISR, acks=all espera a confirmação desse conjunto. Se C fica para trás e sai do ISR, ela deixa de fazer parte dessa espera.
min.insync.replicas estabelece o mínimo exigido para uma escrita bem-sucedida com acks=all. Ele não transforma all em “espere apenas duas”. Com ISR de três e mínimo de dois, a confirmação continua dependendo das três réplicas no ISR.
Esse detalhe é explicitado na documentação de min.insync.replicas.
Para o exemplo, considere um cluster sem Eligible Leader Replicas (ELR) habilitado:
# Producer
acks=all
enable.idempotence=true

# Tópico: criado com fator de replicação 3
min.insync.replicas=2
Com A e B no ISR, a escrita pode ser confirmada. Se restar apenas A, o mínimo não é atendido e a publicação não recebe confirmação de sucesso. O exemplo usa um escopo explícito porque ELR altera aspectos dessa configuração.
O custo operacional aparece durante a degradação: o sistema pode deixar de confirmar novas publicações para preservar o compromisso de durabilidade. O serviço precisa saber como lidar com essa indisponibilidade.
Essa discussão complementa o post sobre durabilidade e tolerância a falhas: contar brokers saudáveis não basta para entender a condição de escrita de uma partição.
A escrita pode acontecer sem a confirmação chegar
Existe um caso mais difícil que uma rejeição explícita.
O producer envia o evento. O broker aceita a escrita. A resposta se perde na rede antes de chegar ao cliente.
Producer                 Kafka
   | --- evento ----------> |
   |                        | escrita aceita
   | <--- confirmação -- X  | resposta perdida
   |
   | sem confirmação observada
Do lado do cliente, uma espera pode terminar sem sucesso conhecido. Do lado do Kafka, o registro pode já existir.
Logo, ausência de confirmação não prova ausência de escrita. Essa é a incerteza que torna um retry delicado.
Também vale separar os relógios: o timeout de uma espera da aplicação, como future.get(5, TimeUnit.SECONDS), não cancela automaticamente o envio. O producer pode continuar trabalhando depois que aquela espera termina. Já delivery.timeout.ms limita o período de tentativa de entrega do cliente, incluindo espera e retries, conforme a documentação do producer.
Imagine a API devolver erro, o usuário repetir a operação e a primeira publicação terminar nesse intervalo. Agora existem duas tentativas de negócio, apesar de a primeira resposta ter parecido uma falha definitiva.
Para recuperar esse fluxo, o sistema precisa preservar a identidade da operação e reconhecer resultados incertos. Um booleano chamado enviado costuma ser insuficiente para representar tudo isso.
Retry do cliente e republicação são decisões diferentes
O producer idempotente protege os retries realizados pelo próprio cliente. Uma nova chamada de publicação feita pela aplicação não recebe automaticamente a mesma proteção contra duplicidade. Essa distinção está na documentação de idempotência do KafkaProducer.
Por isso “deu timeout, publique de novo” precisa de mais contexto.
Qual operação está sendo repetida? O eventId continua igual? O consumer consegue reconhecer que recebeu o mesmo fato? Existe uma intenção persistida que permita reconciliar o resultado?
O post sobre idempotência além do consumer aprofunda essa responsabilidade. Se a publicação nasce de uma alteração no banco, o Outbox Pattern ajuda a preservar a intenção de enviar. Ainda é necessário projetar a recuperação e o tratamento de duplicatas.
Há outra fronteira para produtores transacionais: um envio individual concluído não significa que a transação foi confirmada. Consumers com read_committed dependem do commit da transação para ler seus registros. A API transacional do producer separa essas etapas.
O que registrar em produção
Um log útil precisa dizer qual etapa foi observada.
“Envio aceito pelo cliente” ajuda a acompanhar a entrada no fluxo. “Publicação confirmada pelo Kafka” deve corresponder à conclusão observada com a política de ACK adotada. “Processamento concluído” exige evidência do serviço responsável pelo efeito.
Correlacionar essas etapas pelo eventId permite seguir uma ocorrência sem confundir identidade de negócio com posição no log. Tópico, partição e offset ajudam a localizar a escrita; a exceção e o contexto da tentativa ajudam a investigar uma confirmação ausente.
Isso muda a conversa durante um incidente. Em vez de perguntar apenas se “mandou”, o time consegue localizar a última fronteira confirmada e decidir onde recuperar o fluxo.
O ponto que vale fixar
O producer considera o envio concluído segundo o contrato do cliente e a política de confirmação configurada.
Para usar esse resultado como evidência de publicação, a aplicação precisa observar a conclusão e entender o que acks permite afirmar. Quando a confirmação não chega, pode existir uma escrita cujo resultado o cliente desconhece.
E quando ela chega, ainda falta o trabalho do consumer.
Uma arquitetura confiável nomeia essas fronteiras, preserva a identidade do evento e sabe como recuperar o caminho entre elas.